摘要
本文记录了一次在已有 Kubernetes 集群中重建 Prometheus + Grafana 监控系统的完整实践:从清理旧监控、选择兼容 K8s 1.23 的 kube-prometheus-stack 版本,到解决镜像拉取、Webhook Job 失败、节点网络异常等问题,最终实现 K8s 集群监控,并成功接入第一台外部云主机,为后续 300 台云主机统一监控打下基础。
背景:为什么要重建监控系统
最初是由于运行多年的zabbix监控系统监控数据出现异常,难以修复且版本老旧。而现有一套运行了两年多的 Kubernetes 集群:
Kubernetes: v1.23.17
节点规模: 3 个 master + 3 个 worker
系统版本: Ubuntu 20.04
容器运行时: Docker
网络插件: Cilium
存储: nfs-csi / nfs-client
集群里原本已经有一套 Prometheus + Grafana,但它存在几个明显问题:
- Prometheus 是手工 Deployment 部署,不是
kube-prometheus-stack。 - Prometheus 数据目录使用
emptyDir,Pod 重建后历史数据会丢。 - 没有完整的
Alertmanager、kube-state-metrics、Prometheus Operator。 - 历史上有大量
Evicted的 Prometheus Pod。 - 后续还希望监控 300 台外部云主机,原方案不适合继续扩展。
因此最终决定:铲掉旧的 Prometheus/Grafana,重新基于 kube-prometheus-stack 搭建一套更规范的监控系统。
对于生产环境,监控系统不要长期停留在“几个 Deployment + ConfigMap”的状态。使用
kube-prometheus-stack能获得更完整的 Kubernetes 监控能力,也更利于后续维护和升级。
总体方案
最终采用的方案如下:
Kubernetes 集群
  -> kube-prometheus-stack
  -> Prometheus
  -> Grafana
  -> Alertmanager
  -> kube-state-metrics
  -> node-exporter
  -> Prometheus Operator

外部云主机
  -> node_exporter
  -> Prometheus additionalScrapeConfigs
  -> Grafana Node Exporter Dashboard
暴露方式先采用 NodePort,不依赖 Ingress。原因是当时集群里的 ingress-nginx 自身处于异常状态,继续依赖 Ingress 会增加排障复杂度。
访问端口规划:
Grafana:      32000
Prometheus:   32090
Alertmanager: 32093
清理旧监控
旧监控位于 prom 命名空间,确认不再需要旧数据后,直接删除:
kubectl delete ns prom确认删除完成:
kubectl get ns
kubectl get all -n prom
如果返回:
Error from server (NotFound): namespaces "prom" not found说明旧命名空间已经删除完成。
选择 kube-prometheus-stack 版本
当前 Kubernetes 版本是 v1.23.17,不能直接使用最新的 kube-prometheus-stack。
当时 Helm 仓库里最新版本已经到 80.x,但对于 K8s 1.23 来说太新。最终选择:
kube-prometheus-stack: 45.31.1
Prometheus Operator:  v0.65.1
Prometheus:           v2.42.0
Grafana:              9.5.2
更新Helm仓库:
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
查询版本:
helm search repo prometheus-community/kube-prometheus-stack --versions | grep -E ' *4[5-8]\.' | head -50拉取 chart:
helm pull prometheus-community/kube-prometheus-stack \
  --version 45.31.1 \
  --destination /data
或者直接下载:
https://github.com/prometheus-community/helm-charts/releases/download/kube-prometheus-stack-45.31.1/kube-prometheus-stack-45.31.1.tgz后续安装使用本地 chart 包:
/data/kube-prometheus-stack-45.31.1.tgz这样可以避免 Helm 安装过程中反复访问外网失败。
准备镜像到 Harbor
由于集群访问 registry.k8s.io、quay.io、docker.io 不稳定,需要提前把镜像推到内网 Harbor。
本次用到的镜像包括:
docker pull docker.io/bats/bats:v1.4.1
docker pull docker.io/grafana/grafana:9.5.2
docker pull docker.io/library/busybox:1.31.1
docker pull quay.io/kiwigrid/k8s-sidecar:1.22.0
docker pull quay.io/prometheus/alertmanager:v0.25.0
docker pull quay.io/prometheus/node-exporter:v1.5.0
docker pull quay.io/prometheus-operator/prometheus-operator:v0.65.1
docker pull quay.io/prometheus-operator/prometheus-config-reloader:v0.65.1
docker pull quay.io/prometheus/prometheus:v2.42.0
docker pull registry.k8s.io/ingress-nginx/kube-webhook-certgen:v20221220-controller-v1.5.1-58-g787ea74b6
docker pull registry.k8s.io/kube-state-metrics/kube-state-metrics:v2.8.2
推送到 Harbor 后,镜像路径统一为:
harbor.zspt.com/devops/...基础版 monitoring-values.yaml
下面是基础监控栈使用的 /data/monitoring-values.yaml。这一版先完成 Kubernetes 集群自身监控,不提前接入外部云主机;外部主机的 additionalScrapeConfigsSecret 放到安装完成后再追加。
fullnameOverride: kube-prometheus-stack

grafana:
  enabled: true
  adminPassword: "admin123456"

  image:
    repository: harbor.zspt.com/devops/grafana/grafana
    tag: "9.5.2"

  service:
    type: NodePort
    nodePort: 32000

  persistence:
    enabled: true
    type: pvc
    storageClassName: nfs-csi
    accessModes:
      - ReadWriteOnce
    size: 10Gi

  initChownData:
    image:
      repository: harbor.zspt.com/devops/library/busybox
      tag: "1.31.1"

  sidecar:
    image:
      repository: harbor.zspt.com/devops/kiwigrid/k8s-sidecar
      tag: "1.22.0"

  testFramework:
    image: harbor.zspt.com/devops/bats/bats
    tag: "v1.4.1"

prometheus:
  service:
    type: NodePort
    nodePort: 32090
  prometheusSpec:
    image:
      registry: harbor.zspt.com
      repository: devops/prometheus/prometheus
      tag: "v2.42.0"
    scrapeInterval: 30s
    scrapeTimeout: 10s
    evaluationInterval: 30s
    retention: 15d
    retentionSize: 80GB
    storageSpec:
      volumeClaimTemplate:
        spec:
          storageClassName: nfs-csi
          accessModes:
            - ReadWriteOnce
          resources:
            requests:
              storage: 100Gi
    resources:
      requests:
        cpu: "1"
        memory: 4Gi
      limits:
        cpu: "4"
        memory: 8Gi

alertmanager:
  enabled: true
  service:
    type: NodePort
    nodePort: 32093
  alertmanagerSpec:
    image:
      registry: harbor.zspt.com
      repository: devops/prometheus/alertmanager
      tag: "v0.25.0"
    storage:
      volumeClaimTemplate:
        spec:
          storageClassName: nfs-csi
          accessModes:
            - ReadWriteOnce
          resources:
            requests:
              storage: 5Gi
    resources:
      requests:
        cpu: 100m
        memory: 128Mi
      limits:
        cpu: 500m
        memory: 512Mi

prometheusOperator:
  enabled: true
  image:
    registry: harbor.zspt.com
    repository: devops/prometheus-operator/prometheus-operator
    tag: "v0.65.1"
  prometheusConfigReloader:
    image:
      registry: harbor.zspt.com
      repository: devops/prometheus-operator/prometheus-config-reloader
      tag: "v0.65.1"
  admissionWebhooks:
    enabled: true
    patch:
      enabled: true
      image:
        registry: harbor.zspt.com
        repository: devops/ingress-nginx/kube-webhook-certgen
        tag: "v20221220-controller-v1.5.1-58-g787ea74b6"

prometheus-node-exporter:
  image:
    registry: harbor.zspt.com
    repository: devops/prometheus/node-exporter
    tag: "v1.5.0"

kube-state-metrics:
  image:
    registry: harbor.zspt.com
    repository: devops/kube-state-metrics/kube-state-metrics
    tag: "v2.8.2"

nodeExporter:
  enabled: true

kubeStateMetrics:
  enabled: true

defaultRules:
  create: true
这里有几个关键点:
PrometheusPVC 从50Gi提升到100Gi。- Prometheus 内存上限从
4Gi提升到8Gi。 scrapeInterval使用30s,适合后续 300 台主机接入。- 外部云主机通过后续追加的
additionalScrapeConfigsSecret接入。 - 所有镜像都改成 Harbor 地址,避免安装时访问外网失败。
安装前渲染检查
安装前先渲染 YAML:
helm template kube-prometheus-stack /data/kube-prometheus-stack-45.31.1.tgz \
  -n monitoring \
  -f /data/monitoring-values.yaml \
  > /tmp/kube-prometheus-stack-rendered.yaml
检查镜像是否全部来自 Harbor:
grep -E 'image:' /tmp/kube-prometheus-stack-rendered.yaml | sort -u检查 API 版本是否兼容 K8s 1.23:
grep -E '^apiVersion:' /tmp/kube-prometheus-stack-rendered.yaml | sort | uniq确认没有旧 API:
grep -E 'extensions/v1beta1|networking.k8s.io/v1beta1|policy/v1beta1' /tmp/kube-prometheus-stack-rendered.yaml没有输出即可继续。
安装 kube-prometheus-stack
执行安装:
kubectl create ns monitoring

helm install kube-prometheus-stack /data/kube-prometheus-stack-45.31.1.tgz \
  -n monitoring \
  -f /data/monitoring-values.yaml \
  --timeout 15m
检查状态:
helm list -n monitoring
kubectl -n monitoring get pod -o wide
kubectl -n monitoring get svc
kubectl -n monitoring get pvc
正常结果应该包括:
Grafana:       Running
Prometheus:    Running
Alertmanager:  Running
node-exporter: Running
kube-state-metrics: Running
operator: Running
服务端口:
Grafana:      http://10.0.5.21:32000
Prometheus:   http://10.0.5.21:32090
Alertmanager: http://10.0.5.21:32093
Grafana 默认登录:
用户名: admin
密码: admin123456
接入外部云主机
基础监控栈安装完成后,再接入第一台外部云主机。这样流程更清晰:先确保 Prometheus/Grafana 自身运行正常,再通过 additionalScrapeConfigs 扩展外部 target。
第一台外部云主机 IP 是:
10.0.5.56安装 node_exporter
外部云主机安装 node_exporter 的方式如下:
cd /opt

wget https://github.com/prometheus/node_exporter/releases/download/v1.5.0/node_exporter-1.5.0.linux-amd64.tar.gz

tar -xzf node_exporter-1.5.0.linux-amd64.tar.gz

cp node_exporter-1.5.0.linux-amd64/node_exporter /usr/local/bin/
创建运行用户:
useradd --no-create-home --shell /usr/sbin/nologin node_exporter

chown node_exporter:node_exporter /usr/local/bin/node_exporter
创建 systemd 服务:
cat > /etc/systemd/system/node_exporter.service <<'EOF'
[Unit]
Description=Prometheus Node Exporter
After=network.target

[Service]
User=node_exporter
Group=node_exporter
Type=simple
ExecStart=/usr/local/bin/node_exporter --web.listen-address=:9100
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
EOF
启动服务:
systemctl daemon-reload
systemctl enable --now node_exporter
systemctl status node_exporter
本机验证:
curl http://127.0.0.1:9100/metrics | head从 K8s 节点验证:
curl http://10.0.5.56:9100/metrics | head创建外部主机 scrape 配置
确认 node_exporter 可访问后,创建 Prometheus 的额外抓取配置。
为了复用默认的 Node Exporter Dashboard,job_name 不单独命名为 external-cloud-node,而是统一使用默认看板里写死的:
node-exporter/data/additional-scrape-configs.yaml 内容如下:
- job_name: node-exporter
  static_configs:
    - targets:
        - 10.0.5.56:9100
      labels:
        group: cloud
        env: zwsp
        source: external
创建 Secret:
kubectl -n monitoring delete secret additional-scrape-configs --ignore-not-found

kubectl -n monitoring create secret generic additional-scrape-configs \
  --from-file=additional-scrape-configs.yaml=/data/additional-scrape-configs.yaml
然后在 /data/monitoring-values.yaml 的 prometheus.prometheusSpec 下追加:
    additionalScrapeConfigsSecret:
      enabled: true
      name: additional-scrape-configs
      key: additional-scrape-configs.yaml
通过 Helm 升级让配置生效:
helm upgrade kube-prometheus-stack /data/kube-prometheus-stack-45.31.1.tgz \
  -n monitoring \
  -f /data/monitoring-values.yaml \
  --timeout 15m
如果 Prometheus 页面中看到:
node-exporter
10.0.5.56:9100
UP
说明外部云主机已经接入成功。
如果后续新增主机,只需要更新 /data/additional-scrape-configs.yaml、重建 Secret,并再次执行 helm upgrade。
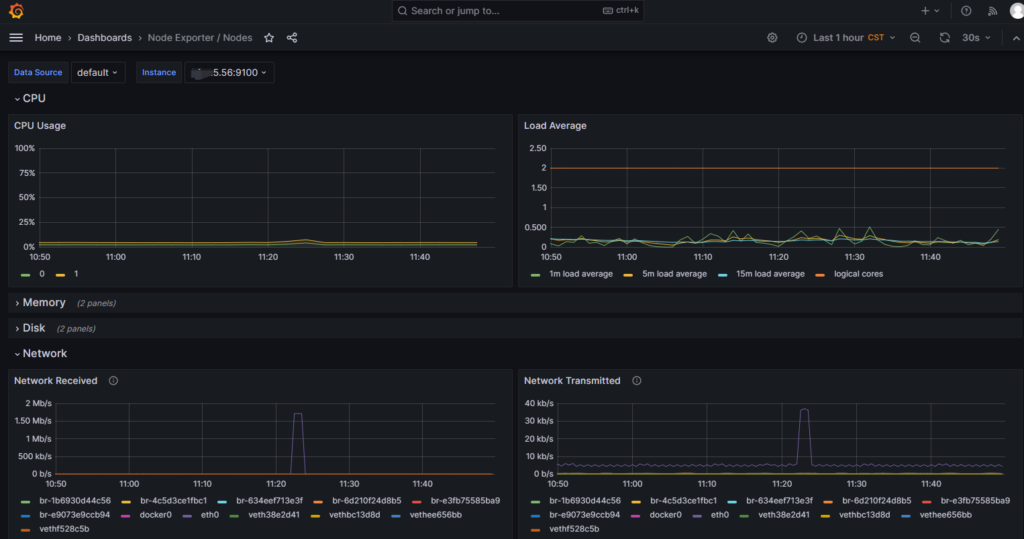
Grafana 看板适配
安装完成后,Grafana 默认会带一些 Node Exporter Dashboard,例如:
Node Exporter / Nodes
Node Exporter / USE Method / Node
一开始我将外部主机的 job 命名成了:
external-cloud-nodePrometheus 能抓到数据,但 Grafana 默认看板没有数据。原因是这些看板里的 PromQL 写死了:
job="node-exporter"例如 CPU 面板中类似:
node_cpu_seconds_total{job="node-exporter", instance="$instance"}因此,最佳做法不是逐个修改面板,而是让外部主机也使用相同的 job_name:
job_name: node-exporter这样外部主机就能直接复用默认 Dashboard。
不要为了接入外部主机去手工改几十个 Grafana 面板。更推荐统一 Prometheus 标签和 job 命名,让 Dashboard 自然复用。
最终效果:
踩坑与避坑指南
坑一:最新版 chart 不一定适合旧 K8s
当前 K8s 是 1.23.17,而 kube-prometheus-stack 最新版本已经到 80+。直接安装最新版可能带来 API 兼容性问题。
最终选择 45.31.1,它的 Operator 版本是 v0.65.1,对 K8s 1.23 更稳妥。
坑二:Helm install 时下载失败
曾经遇到:
Error: INSTALLATION FAILED: failed to download "prometheus-community/kube-prometheus-stack" at version "45.31.1"解决方式是先 helm pull 到本地:
helm pull prometheus-community/kube-prometheus-stack \
  --version 45.31.1 \
  --destination /data
然后使用本地 .tgz 安装:
helm install kube-prometheus-stack /data/kube-prometheus-stack-45.31.1.tgz \
  -n monitoring \
  -f /data/monitoring-values.yaml
坑三:registry.k8s.io 镜像拉取失败
安装时 admission webhook Job 拉取镜像失败:
Failed to pull image "registry.k8s.io/ingress-nginx/kube-webhook-certgen:..."解决方式是把所有镜像提前同步到 Harbor,并在 monitoring-values.yaml 中覆盖镜像地址。
坑四:Grafana chart 的镜像配置格式不一致
一开始把 Grafana 镜像写成了:
image:
  registry: harbor.zspt.com
  repository: devops/grafana/grafana
  tag: "9.5.2"
渲染后发现镜像变成:
devops/grafana/grafana:9.5.2没有带 harbor.zspt.com。
Grafana 子 chart 这里需要写成:
image:
  repository: harbor.zspt.com/devops/grafana/grafana
  tag: "9.5.2"
另外 grafana.testFramework.image 是字符串,不是 map。错误写法会渲染出:
map[registry:harbor.zspt.com repository:devops/bats/bats tag:v1.4.1]:v1.4.1正确写法是:
testFramework:
  image: harbor.zspt.com/devops/bats/bats
  tag: "v1.4.1"
坑五:worker-3 Pod 网络异常导致 Webhook Job 失败
安装时 admission Job 一直失败,日志如下:
Get "https://10.96.0.1:443/api/v1/namespaces/monitoring/secrets/kube-prometheus-stack-admission": dial tcp 10.96.0.1:443: i/o timeout测试发现:
kubectl -n monitoring exec api-test-worker3 -- wget -S -O- --timeout=5 https://10.96.0.1:443结果是 timeout。
而在 worker-2 上测试:
HTTP/1.1 403 Forbidden这说明 worker-2 网络是通的,只是没有认证;worker-3 才是真正网络不通。
临时处理方式:
kubectl cordon k8s-worker-3然后重新安装。这样普通 Pod 不会再调度到 worker-3,安装成功。
需要注意,node-exporter 是 DaemonSet,仍然会跑到 worker-3 上,这是正常的。
坑六:controller-manager、scheduler、etcd 显示 DOWN
Prometheus Targets 中曾看到:
kube-controller-manager 0/3 up
kube-scheduler          0/3 up
kube-etcd               0/3 up
这是 kubeadm 集群常见现象,不代表 Prometheus 安装失败。
通常原因是:
controller-manager 和 scheduler metrics 默认监听 127.0.0.1
etcd metrics 可能需要额外证书、端口和 ServiceMonitor 配置
第一阶段可以先不处理,核心监控先跑起来。后续再专门修 scheduler、controller-manager、etcd 的 metrics 暴露。
300 台云主机能不能扛住
只监控 node_exporter,300 台对单实例 Prometheus 来说不算大,但要做好资源规划。
本次配置做了几项调整:
scrapeInterval: 30s
scrapeTimeout: 10s
retention: 15d
retentionSize: 80GB
storage: 100Gi
memory limit: 8Gi
如果后续还要接入 MySQL、Redis、Nginx、JVM 等 exporter,需要继续观察 Prometheus 的资源指标。
建议重点关注:
prometheus_tsdb_head_series
rate(prometheus_tsdb_head_samples_appended_total[5m])
prometheus_target_scrape_pool_targets
process_resident_memory_bytes
接入顺序建议分批:
第一批:5 台
第二批:30 台
第三批:100 台
第四批:300 台
不要一次性把所有主机加入,避免问题定位困难。
总结
这次实践的核心把 Prometheus 升级成一套更适合长期维护的 Kubernetes 监控栈。
最终方案具备几个优点:
- 使用
kube-prometheus-stack,组件完整。 - 所有镜像走 Harbor,适合内网环境。
- Prometheus 使用 PVC 持久化,避免数据随 Pod 丢失。
- 通过
additionalScrapeConfigs接入外部云主机。 - 统一使用
job_name: node-exporter,复用默认 Grafana Dashboard。 - 为后续 300 台云主机接入预留了资源和标签规范。
 ixdongqing