摘要
本文记录一次 Linux 自动化巡检体系的落地过程:基于 NetBox 动态 Inventory 获取华为云主机资产,使用 Ansible 对 Linux 主机进行磁盘、内存、负载、NTP、OOM 等健康检查,并生成 JSON 与 Markdown 报告。文章重点总结了报告生成被 --limit 过滤、NTP 误报、UTC 时间显示等真实踩坑及修复方案。
背景:为什么要把 Linux 巡检做成自动化
在云主机数量不断增加后,Linux 巡检很容易从“顺手看一下”变成一件低效且高风险的事情。
常见做法是登录服务器,手动执行 df -h、free -m、uptime、timedatectl、dmesg 等命令。这种方式适合临时排查,却不适合作为长期运维机制:
- 主机多了以后,人工巡检容易漏机器。
- 不同人执行的命令和判断标准不一致。
- 巡检结果难以沉淀,无法形成历史报告。
- 环境、业务、主机归属等信息与巡检动作脱节。
- 巡检范围经常靠手工 IP 列表维护,容易过期。
在前面的 CMDB 建设中,我们已经把华为云主机资产同步到了 NetBox,并通过 NetBox Dynamic Inventory 给 Ansible 提供主机清单。因此,Linux 巡检的思路就很自然了:
NetBox 负责告诉 Ansible 要巡检哪些机器,Ansible 负责只读采集运行状态,最终在控制机生成可读、可归档的巡检报告。
这篇文章重点讲 Linux 巡检这部分的实现,不展开 NetBox 建模、华为云 API 同步等已有内容。
总体设计思路
这套巡检方案遵循三个原则。
第一,巡检对象来自 NetBox 动态 Inventory。
Ansible 不再维护静态 hosts.ini。Linux 主机通过 NetBox 中的自定义字段 login_protocol=ssh 进入动态组 protocol_ssh,按环境可以继续使用 env_dmztest 这样的动态组过滤。
第二,巡检动作只读,不自动修复。
Playbook 中设置 become: false,默认不提权、不改配置。巡检阶段只回答一个问题:当前主机是否健康,哪里需要关注。
第三,报告在 Ansible 控制机本地生成。
每次巡检输出两份报告:
JSON:方便后续被平台、脚本或流水线消费。Markdown:方便人工阅读、归档或直接贴到工单系统。
最终控制机目录如下:
/data/ansible-deploy/
├── ansible.cfg
├── inventories/
│   └── netbox.yml
├── playbooks/
│   └── 02-vm-ops/
│       └── inspect/
│           ├── linux_health_check.yml
│           ├── tasks/
│           │   ├── assemble.yml
│           │   ├── disk.yml
│           │   ├── load.yml
│           │   ├── memory.yml
│           │   └── services.yml
│           ├── templates/
│           │   └── health_report.md.j2
│           └── vars/
│               └── defaults.yml
└── reports/
    └── inspect/
巡检范围与运行方式
全量巡检 protocol_ssh 主机:
cd /data/ansible-deploy

ansible-playbook -i inventories/netbox.yml \
  playbooks/02-vm-ops/inspect/linux_health_check.yml
按环境巡检,例如只检查 env_dmztest:
cd /data/ansible-deploy

ansible-playbook -i inventories/netbox.yml \
  playbooks/02-vm-ops/inspect/linux_health_check.yml \
  --limit env_dmztest
如果想先探活,只巡检可达主机,可以先生成一个临时 limit 文件:
cd /data/ansible-deploy

ansible -i inventories/netbox.yml protocol_ssh -m ping -o 2>/dev/null \
  | grep SUCCESS | awk '{print $1}' > /tmp/alive_vms.txt

ansible-playbook -i inventories/netbox.yml \
  playbooks/02-vm-ops/inspect/linux_health_check.yml \
  --limit @/tmp/alive_vms.txt
核心实现:主 Playbook
主文件是 playbooks/02-vm-ops/inspect/linux_health_check.yml。它做了三件事:
- 对
protocol_ssh组里的 Linux 主机执行巡检。 - 每台主机生成一个
health_audit结果对象。 - 使用
delegate_to: localhost在控制机本地生成报告。
最终版核心代码如下:
---
- name: Linux health inspection
  hosts: protocol_ssh
  gather_facts: true
  become: false
  ignore_unreachable: true
  vars_files:
    - vars/defaults.yml
  vars:
    inspect_report_base: "{{ (playbook_dir | dirname | dirname | dirname, inspect_report_dir) | path_join }}"

  pre_tasks:
    - name: Skip host when facts were not gathered
      ansible.builtin.meta: end_host
      when: ansible_distribution is not defined

    - name: Skip non-Linux hosts
      ansible.builtin.meta: end_host
      when: ansible_os_family != 'RedHat' and ansible_os_family != 'Debian' and ansible_os_family != 'Suse'

  tasks:
    - name: Run disk checks
      ansible.builtin.include_tasks: tasks/disk.yml

    - name: Run memory checks
      ansible.builtin.include_tasks: tasks/memory.yml

    - name: Run load checks
      ansible.builtin.include_tasks: tasks/load.yml

    - name: Run service and runtime checks
      ansible.builtin.include_tasks: tasks/services.yml

    - name: Assemble per-host audit record
      ansible.builtin.include_tasks: tasks/assemble.yml

  post_tasks:
    - name: Mark unreachable hosts in audit
      ansible.builtin.set_fact:
        health_audit:
          host: "{{ inventory_hostname }}"
          ansible_host: "{{ ansible_host | default('') }}"
          inspected_at: "{{ ansible_date_time.iso8601 }}"
          reachable: false
          status: unreachable
          warn_count: 0
          crit_count: 0
          findings: []
          message: "Host unreachable or facts not gathered"
      when: health_audit is not defined

    - name: Generate inspection reports on controller
      run_once: true
      delegate_to: localhost
      become: false
      vars:
        inspect_target_hosts: "{{ ansible_play_hosts_all }}"
        _report_ts: "{{ lookup('pipe', 'TZ=Asia/Shanghai date +%Y%m%dT%H%M%S') }}"
        report_generated_at: "{{ lookup('pipe', 'TZ=Asia/Shanghai date \"+%Y-%m-%d %H:%M:%S CST (UTC+8)\"') }}"
        inspect_all_audits: >-
          {{
            (ansible_play_hosts_all | default([]))
            | map('extract', hostvars, 'health_audit')
            | select('defined')
            | list
          }}
      block:
        - name: Ensure report directory exists
          ansible.builtin.file:
            path: "{{ inspect_report_base }}"
            state: directory
            mode: "0755"

        - name: Build summary counts
          ansible.builtin.set_fact:
            inspect_summary:
              total: "{{ ansible_play_hosts_all | default([]) | length }}"
              audited: "{{ inspect_all_audits | length }}"
              ok: "{{ inspect_all_audits | selectattr('status', 'equalto', 'ok') | list | length }}"
              warn: "{{ inspect_all_audits | selectattr('status', 'equalto', 'warn') | list | length }}"
              crit: "{{ inspect_all_audits | selectattr('status', 'equalto', 'crit') | list | length }}"
              unreachable: "{{ inspect_all_audits | selectattr('status', 'equalto', 'unreachable') | list | length }}"

        - name: Write JSON report
          ansible.builtin.copy:
            dest: "{{ inspect_report_base }}/linux_health_{{ _report_ts }}.json"
            mode: "0644"
            content: "{{ {'summary': inspect_summary | combine({'generated_at': report_generated_at}), 'hosts': inspect_all_audits} | to_nice_json }}"

        - name: Write Markdown report
          ansible.builtin.template:
            src: templates/health_report.md.j2
            dest: "{{ inspect_report_base }}/linux_health_{{ _report_ts }}.md"
            mode: "0644"

        - name: Show report paths
          ansible.builtin.debug:
            msg:
              - "JSON: {{ inspect_report_base }}/linux_health_{{ _report_ts }}.json"
              - "Markdown: {{ inspect_report_base }}/linux_health_{{ _report_ts }}.md"
              - "Summary: ok={{ inspect_summary.ok }} warn={{ inspect_summary.warn }} crit={{ inspect_summary.crit }} unreachable={{ inspect_summary.unreachable }}"
这段代码里最关键的是 post_tasks 的报告生成逻辑。报告不是放在第二个 localhost Play 里生成,而是挂在第一个 Play 里,通过 delegate_to: localhost 在控制机执行。
这是一个很重要的设计点:如果使用 NetBox 动态 Inventory,
localhost往往不在 inventory 中;再加上--limit会过滤所有 Play,单独的localhostPlay 很容易被跳过。
巡检阈值配置
阈值统一放在 vars/defaults.yml 中,便于后续按环境或临时任务覆盖。
---
inspect_fstypes:
  - ext4
  - ext3
  - xfs
  - btrfs
  - nfs
  - nfs4

inspect_mount_prefixes: []

disk_warn_pct: 80
disk_crit_pct: 90
inode_warn_pct: 80
inode_crit_pct: 90

mem_warn_pct: 85
mem_crit_pct: 95

swap_warn_pct: 50
swap_crit_pct: 80

load_warn_factor: 1.0
load_crit_factor: 2.0

zombie_warn_count: 5
zombie_crit_count: 20

inspect_report_dir: reports/inspect
其中 inspect_report_dir 是相对 /data/ansible-deploy 项目根目录的路径。默认报告会写到:
/data/ansible-deploy/reports/inspect/临时调整阈值时,不需要改文件,可以通过 -e 覆盖:
ansible-playbook -i inventories/netbox.yml \
  playbooks/02-vm-ops/inspect/linux_health_check.yml \
  --limit env_dmztest \
  -e disk_warn_pct=75 -e disk_crit_pct=85
磁盘、内存与负载检查
磁盘检查基于 Ansible facts 中的 ansible_mounts,只筛选真实文件系统类型,例如 ext4、xfs、btrfs。inode 使用率则通过 df -Pi 获取。
- name: Filter mounts for inspection
  ansible.builtin.set_fact:
    _inspect_mounts: >-
      {{
        ansible_mounts
        | selectattr('fstype', 'in', inspect_fstypes)
        | selectattr('size_total', 'gt', 0)
        | list
      }}

- name: Evaluate disk space usage
  ansible.builtin.set_fact:
    health_disk_findings: "{{ health_disk_findings | default([]) + [finding] }}"
  vars:
    _used_pct: "{{ (((item.size_total | float) - (item.size_available | float)) / (item.size_total | float) * 100) | round(1) }}"
    finding:
      check: disk
      mount: "{{ item.mount }}"
      fstype: "{{ item.fstype }}"
      used_pct: "{{ _used_pct }}"
      status: >-
        {{
          'crit' if (_used_pct | float) >= (disk_crit_pct | float)
          else ('warn' if (_used_pct | float) >= (disk_warn_pct | float) else 'ok')
        }}
      message: "{{ item.mount }} {{ _used_pct }}% used"
  loop: "{{ _inspect_mounts }}"
内存检查没有直接使用 free 命令,而是基于 facts 计算:
- name: Calculate memory usage percent
  ansible.builtin.set_fact:
    _mem_used_pct: >-
      {{
        (
          (
            (ansible_memtotal_mb | float)
            - (ansible_memfree_mb | float)
            - (ansible_buffers_mb | default(0) | float)
            - (ansible_caches_mb | default(0) | float)
          )
          / (ansible_memtotal_mb | float)
          * 100
        ) | round(1)
      }}
  when: ansible_memtotal_mb | int > 0
负载检查按 1 分钟负载 与 vCPU 的比例判断。默认逻辑是:
load_1m > vCPU * 1.0判为warn。load_1m > vCPU * 2.0判为crit。
- name: Evaluate load average
  ansible.builtin.set_fact:
    health_load_finding:
      check: load
      load_1m: "{{ ansible_loadavg['1m'] }}"
      load_5m: "{{ ansible_loadavg['5m'] }}"
      load_15m: "{{ ansible_loadavg['15m'] }}"
      vcpus: "{{ ansible_processor_vcpus | default(1) }}"
      status: >-
        {{
          'crit' if (ansible_loadavg['1m'] | float) > ((ansible_processor_vcpus | default(1) | float) * (load_crit_factor | float))
          else (
            'warn' if (ansible_loadavg['1m'] | float) > ((ansible_processor_vcpus | default(1) | float) * (load_warn_factor | float))
            else 'ok'
          )
        }}
      message: >-
        Load {{ ansible_loadavg['1m'] }}/{{ ansible_loadavg['5m'] }}/{{ ansible_loadavg['15m'] }}
        (vCPU {{ ansible_processor_vcpus | default(1) }})
NTP、僵尸进程与 OOM 检查
最初巡检里包含 systemctl --failed,但实际使用中决定取消 systemd failed 巡检。原因很简单:不同业务对失败单元的容忍度不同,一些历史残留 unit 可能长期 failed,但并不等于当前业务异常。
当前 services.yml 只保留三类检查:僵尸进程、NTP、OOM。
---
- name: Count zombie processes
  ansible.builtin.shell: |
    set -o pipefail
    ps -eo stat= | grep -c '^Z' || true
  args:
    executable: /bin/bash
  register: _zombie_count
  changed_when: false
  failed_when: false

- name: Record zombie finding
  ansible.builtin.set_fact:
    health_zombie_finding:
      check: zombie
      count: "{{ _zombie_count.stdout | default('0') | trim | int }}"
      status: >-
        {{
          'crit' if (_zombie_count.stdout | default('0') | trim | int) >= (zombie_crit_count | int)
          else (
            'warn' if (_zombie_count.stdout | default('0') | trim | int) >= (zombie_warn_count | int)
            else 'ok'
          )
        }}
      message: "{{ _zombie_count.stdout | default('0') | trim }} zombie process(es)"

- name: Check NTP synchronization
  ansible.builtin.shell: |
    set -o pipefail
    v=""
    if command -v timedatectl >/dev/null 2>&1; then
      v=$(timedatectl show -p NTPSynchronized --value 2>/dev/null | tr -d '[:space:]')
      if [ -z "$v" ]; then
        v=$(timedatectl 2>/dev/null | awk -F': *' 'tolower($1) ~ /ntp synchronized/{print $2; exit}' | tr -d '[:space:]')
      fi
    fi
    echo "${v:-unknown}"
  args:
    executable: /bin/bash
  register: _ntp_sync
  changed_when: false
  failed_when: false

- name: Record time sync finding
  ansible.builtin.set_fact:
    health_ntp_finding:
      check: ntp
      ntp_synchronized: "{{ _ntp_val }}"
      status: "{{ 'warn' if not _ntp_ok else 'ok' }}"
      message: >-
        {{
          'NTP synchronized'
          if _ntp_ok
          else ('NTP not synchronized (raw=' ~ (_ntp_val | default('unknown')) ~ ')')
        }}
  vars:
    _ntp_val: "{{ (_ntp_sync.stdout | default('') | trim | lower) }}"
    _ntp_ok: "{{ _ntp_val in ['yes', 'y', '1', 'true'] }}"

- name: Recent OOM in kernel ring buffer
  ansible.builtin.shell: |
    set -o pipefail
    dmesg 2>/dev/null | grep -i 'out of memory' | tail -3
  args:
    executable: /bin/bash
  register: _dmesg_oom
  changed_when: false
  failed_when: false

- name: Record OOM finding
  ansible.builtin.set_fact:
    health_oom_finding:
      check: oom
      recent_lines: "{{ _oom_lines }}"
      status: "{{ 'warn' if (_oom_lines | length) > 0 else 'ok' }}"
      message: >-
        {{
          'No recent OOM in dmesg'
          if (_oom_lines | length) == 0
          else ('OOM messages in dmesg (' ~ (_oom_lines | length) ~ ' line(s))')
        }}
  vars:
    _oom_lines: "{{ _dmesg_oom.stdout_lines | default([]) | map('trim') | reject('equalto', '') | list }}"
这里最容易踩坑的是 NTP。某些 CentOS 7 主机上,手工执行 timedatectl 可以看到:
NTP synchronized: yes但执行下面命令时可能没有输出:
timedatectl show -p NTPSynchronized --value因此最终代码做了回退:如果 show -p 无结果,就解析 timedatectl 的完整输出。
汇总每台主机的巡检结果
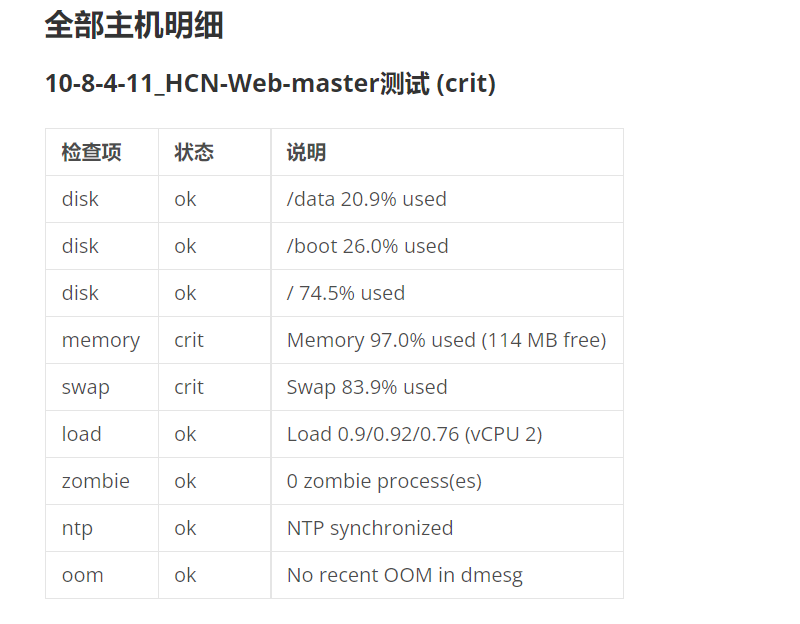
所有检查项最终都归并到 health_audit,每台主机只有一个结果对象。
---
- name: Merge all check findings
  ansible.builtin.set_fact:
    _health_all_findings: >-
      {{
        (health_disk_findings | default([]))
        + (health_inode_findings | default([]))
        + ([health_memory_finding] if health_memory_finding is defined else [])
        + ([health_swap_finding] if health_swap_finding is defined and health_swap_finding.status != 'skip' else [])
        + ([health_load_finding] if health_load_finding is defined else [])
        + ([health_zombie_finding] if health_zombie_finding is defined else [])
        + ([health_ntp_finding] if health_ntp_finding is defined else [])
        + ([health_oom_finding] if health_oom_finding is defined else [])
      }}

- name: Compute host overall status
  ansible.builtin.set_fact:
    health_audit:
      host: "{{ inventory_hostname }}"
      ansible_host: "{{ ansible_host | default('') }}"
      environment: "{{ custom_fields.environment | default('') }}"
      business_owner: "{{ custom_fields.business_owner | default('') }}"
      platform: "{{ ansible_distribution | default('') }} {{ ansible_distribution_version | default('') }}"
      inspected_at: "{{ ansible_date_time.iso8601 }}"
      reachable: true
      uptime_seconds: "{{ ansible_uptime_seconds | default(0) }}"
      warn_count: "{{ _health_all_findings | selectattr('status', 'equalto', 'warn') | list | length }}"
      crit_count: "{{ _health_all_findings | selectattr('status', 'equalto', 'crit') | list | length }}"
      status: >-
        {{
          'crit' if (_health_all_findings | selectattr('status', 'equalto', 'crit') | list | length) > 0
          else (
            'warn' if (_health_all_findings | selectattr('status', 'equalto', 'warn') | list | length) > 0
            else 'ok'
          )
        }}
      findings: "{{ _health_all_findings }}"
判断规则很直接:只要存在一个 crit,整台主机就是 crit;没有 crit 但有 warn,整台主机就是 warn;否则是 ok。
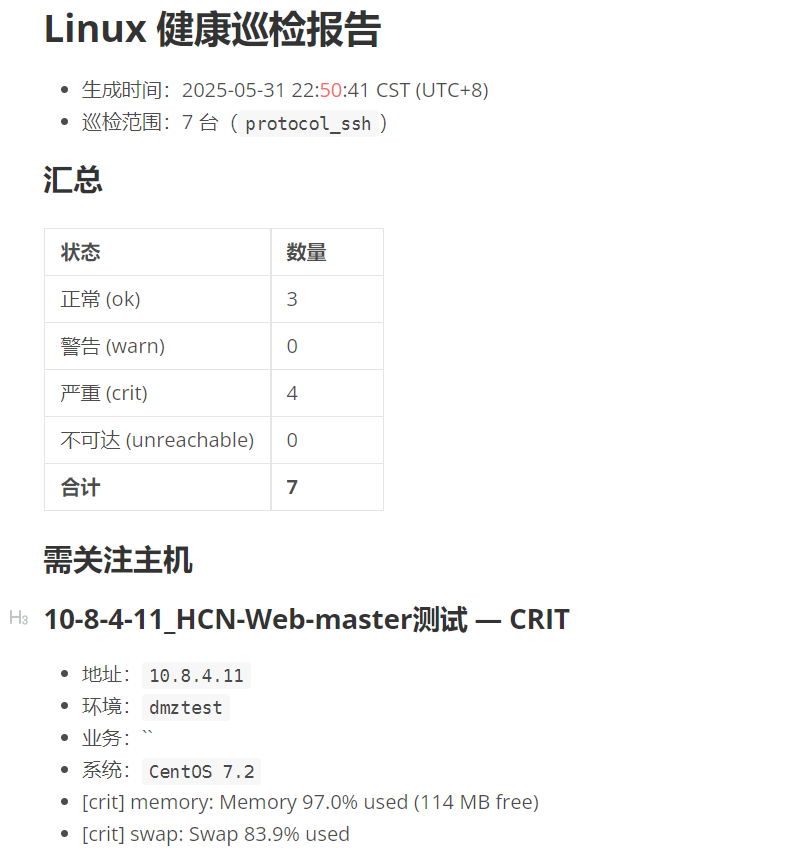
Markdown 报告模板
报告模板使用 Jinja2,输出面向人工阅读的 Markdown。
# Linux 健康巡检报告

- 生成时间:{{ report_generated_at }}
- 巡检范围:{{ inspect_target_hosts | default([]) | length }} 台(`protocol_ssh`)

## 汇总

| 状态 | 数量 |
|------|------|
| 正常 (ok) | {{ inspect_summary.ok }} |
| 警告 (warn) | {{ inspect_summary.warn }} |
| 严重 (crit) | {{ inspect_summary.crit }} |
| 不可达 (unreachable) | {{ inspect_summary.unreachable }} |
| **合计** | **{{ inspect_summary.total }}** |

## 需关注主机

{% for h in inspect_all_audits | selectattr('status', 'in', ['warn', 'crit', 'unreachable']) | sort(attribute='host') %}
### {{ h.host }} — {{ h.status | upper }}

- 地址:`{{ h.ansible_host }}`
- 环境:`{{ h.environment | default('-') }}`
- 业务:`{{ h.business_owner | default('-') }}`
- 系统:`{{ h.platform | default('-') }}`
{% if not h.reachable | default(true) %}
- **不可达**:{{ h.message | default('facts 未采集') }}
{% else %}
{% for f in h.findings | selectattr('status', 'in', ['warn', 'crit']) %}
- [{{ f.status }}] {{ f.check }}: {{ f.message }}
{% endfor %}
{% endif %}

{% else %}
无 warn/crit/unreachable 主机。
{% endfor %}
报告文件名使用北京时间,例如:
linux_health_20250601T100800.json
linux_health_20250601T100800.md
报告正文时间也使用北京时间:
2025-06-01 10:08:00 CST (UTC+8)踩坑与避坑指南
坑一:localhost 不在 NetBox 动态 Inventory 中
一开始报告生成使用了一个单独的 Play:
- name: Generate inspection reports on controller
  hosts: localhost
执行时出现:
PLAY [Generate inspection reports on controller]
skipping: no hosts matched
原因是 NetBox 动态 Inventory 中只有云主机,没有 localhost。
最终解决方法是:不要使用单独的 localhost Play,而是在目标主机 Play 的 post_tasks 中通过 delegate_to: localhost 生成报告。
坑二:--limit 会过滤所有 Play
后来尝试用 add_host 动态添加一个 _ansible_report_local,但带 --limit env_dmztest 后仍然失败。
原因是 --limit 会作用于整个 playbook 的所有 Play,动态添加的本地主机不属于 env_dmztest,所以第二个 Play 仍然被过滤掉。
这个问题同样通过 delegate_to: localhost 解决,因为报告生成任务仍挂在已匹配的目标主机 Play 下。
坑三:报告路径里出现 ../../../
旧写法直接拼路径:
inspect_report_base: "{{ playbook_dir }}/../../../{{ inspect_report_dir }}"实际输出类似:
/data/ansible-deploy/playbooks/02-vm-ops/inspect/../../../reports/inspect/...虽然 Linux 可以正确解析,但日志看起来很别扭。最终改成:
inspect_report_base: "{{ (playbook_dir | dirname | dirname | dirname, inspect_report_dir) | path_join }}"输出就变成了干净路径:
/data/ansible-deploy/reports/inspect/...坑四:CentOS 7 的 NTP 误报
手工执行 timedatectl 能看到:
NTP synchronized: yes但 timedatectl show -p NTPSynchronized --value 可能没有输出,导致巡检误判。
最终策略是先用结构化输出,失败后再解析完整输出中的 NTP synchronized: 字段。
坑五:报告时间显示 UTC
报告中曾出现:
2025-05-31T14:44:49Z这里的 Z 表示 UTC 时间,比北京时间少 8 小时。对于国内运维人员来说,这种时间很容易误解。
最终改为:
TZ=Asia/Shanghai date "+%Y-%m-%d %H:%M:%S CST (UTC+8)"这样报告正文和文件名都使用北京时间。
坑六:systemd failed 不一定等于业务异常
systemctl --failed 看似很适合巡检,但实际环境中可能存在历史残留 unit、一次性失败服务、业务无关服务等情况。把它直接纳入通用巡检,很容易产生噪音。
所以最终取消了 systemd failed 巡检。对于确实需要关注的服务,后续更建议做成按业务定制的服务检查,例如只检查 sshd、nginx、mysql 或某个业务进程。
最终效果
一次成功执行后,控制台会打印类似结果:
TASK [Show report paths]
ok: [10-8-4-11_HCN-Web-master测试 -> localhost] =>
  msg:
  - 'JSON: /data/ansible-deploy/reports/inspect/linux_health_20250601T100800.json'
  - 'Markdown: /data/ansible-deploy/reports/inspect/linux_health_20250601T100800.md'
  - 'Summary: ok=0 warn=3 crit=4 unreachable=0'
报告目录中可以看到:
ls -lt /data/ansible-deploy/reports/inspect/Markdown 报告适合人读,JSON 报告适合后续接入平台、告警或流水线。
总结
这次 Linux 巡检的价值不只是写了一个 Ansible Playbook,而是把巡检纳入了统一的资产和自动化体系:
- 用
NetBox动态 Inventory 解决“巡检哪些机器”的问题。 - 用 Ansible facts 和只读命令解决“检查什么、怎么判断”的问题。
- 用 Markdown 与 JSON 报告解决“结果如何沉淀”的问题。
最终形成的是一条可扩展的 Linux 健康巡检链路:华为云资产进入 NetBox,NetBox 提供动态主机清单,Ansible 执行只读巡检,报告在控制机或 gitlab CI Artifact (下一步工作)中沉淀。
后续如果要继续增强,可以按业务逐步增加定制检查,例如指定服务存活、证书到期时间、关键端口监听、日志错误率等。但基础原则不变:先稳定地产出可信报告,再决定哪些问题可以自动修复。
 ixdongqing